Digital twin Dominiki — testy lokalne (15.09.2026)

Wszystko policzone u nas (4× DGX Spark GB10, ComfyUI). Ten sam skrypt w każdej próbie. Materiał: nagrania Dominiki z 14.09 (twin-nagrania-2026-09). Strona robocza, niepubliczna (noindex) — wizerunek i głos to dane biometryczne.

Skrypt testowy (ten sam we wszystkich próbach)
  1. Cześć! Mam na imię Dominika i jestem z Numeriki. To jest test dłuższego tekstu.
  2. Bartosz Paszek to najlepszy wspólnik. Trafił mi się jak ślepej kurze ziarno.
  3. Legia Warszawa to najlepszy klub, a kto nie wierzy, chuj mu w dziób.
  4. Kocham Czarodziejkę z Księżyca. I wiem, że czterdzieści plus sześćdziesiąt daje sto.
  5. Jest taka supertajna formuła w Excelu. Nazywa się SUMA. Ale nikomu nie mówcie.
  6. Excel to jedyny program, który zamienia datę urodzenia w liczbę czterdzieści cztery tysiące.
  7. Otwierasz plik, a on pyta, czy zapisać zmiany. Jakie zmiany? Ja tylko patrzyłam!
  8. Scal komórki to nie funkcja. To pułapka na ludzi, którzy ufają Excelowi. Koniec testu!
Co wygrało (stan 15.09.2026, ~15:30 UTC):
Diagnoza glitchy i artefaktów (16:05 UTC) — dlaczego to widać i co z tym zrobić

Policzone per klatka dla każdego filmu (zmiana klatka→klatka, ostrość, jasność) i porównane z prawdziwym nagraniem IMG_5150. Pełny raport: twin-test/diag/DIAGNOZA-ARTEFAKTOW-2026-09-15.md (Drive). Dowody: arkusz 1 — klatki startowe, szarpnięcia, dryf · arkusz 2 — faktura (oryginał vs silniki).

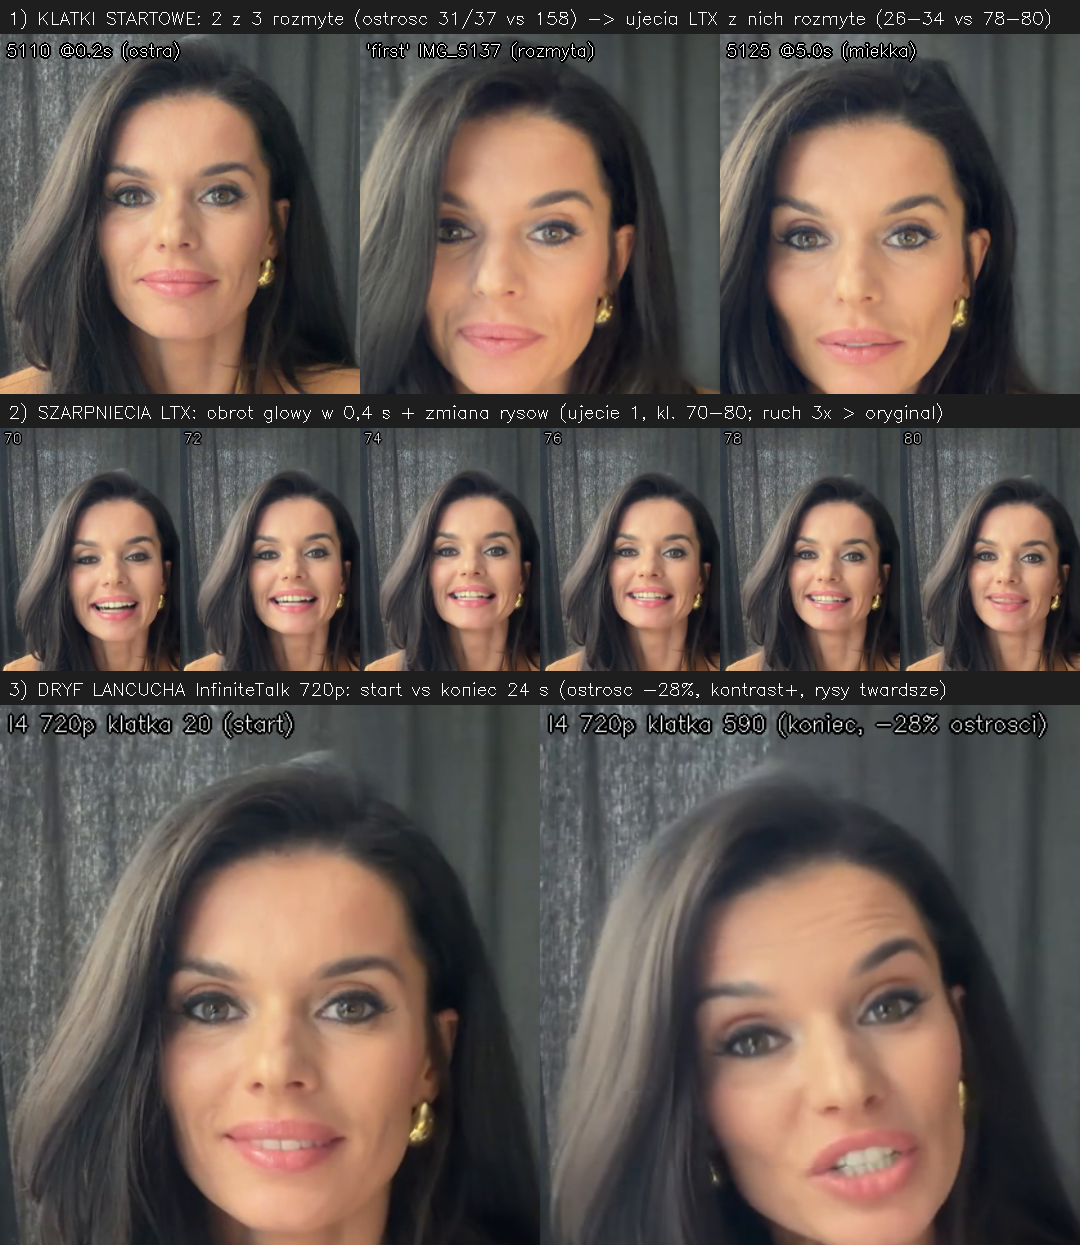
  1. Rozmyte klatki startowe (główna przyczyna „mydła" w LTX): 2 z 3 klatek referencyjnych są nieostre (ostrość 31/37 vs 158 dla IMG_5110 @0,2 s); ujęcia z nich dziedziczą rozmycie 1:1 (26–34 vs 78–80). ID-LoRA tego nie naprawia. → wybór klatek po ostrości, statyw i AF-lock przy nagraniach.
  2. Szarpnięcia i „zmiana twarzy" w LTX: obrót głowy w 0,4 s, kołysanie tułowia (ruch 3× ponad oryginał w ujęciach 6–8), w tych klatkach rysy się zmieniają — 8 kroków distilled + cfg 1 + prompt bez ograniczenia ruchu. → „static shot, subtle head movement", krótsze kwestie, 2–3 seedy + automatyczny wybór, 704×1280.
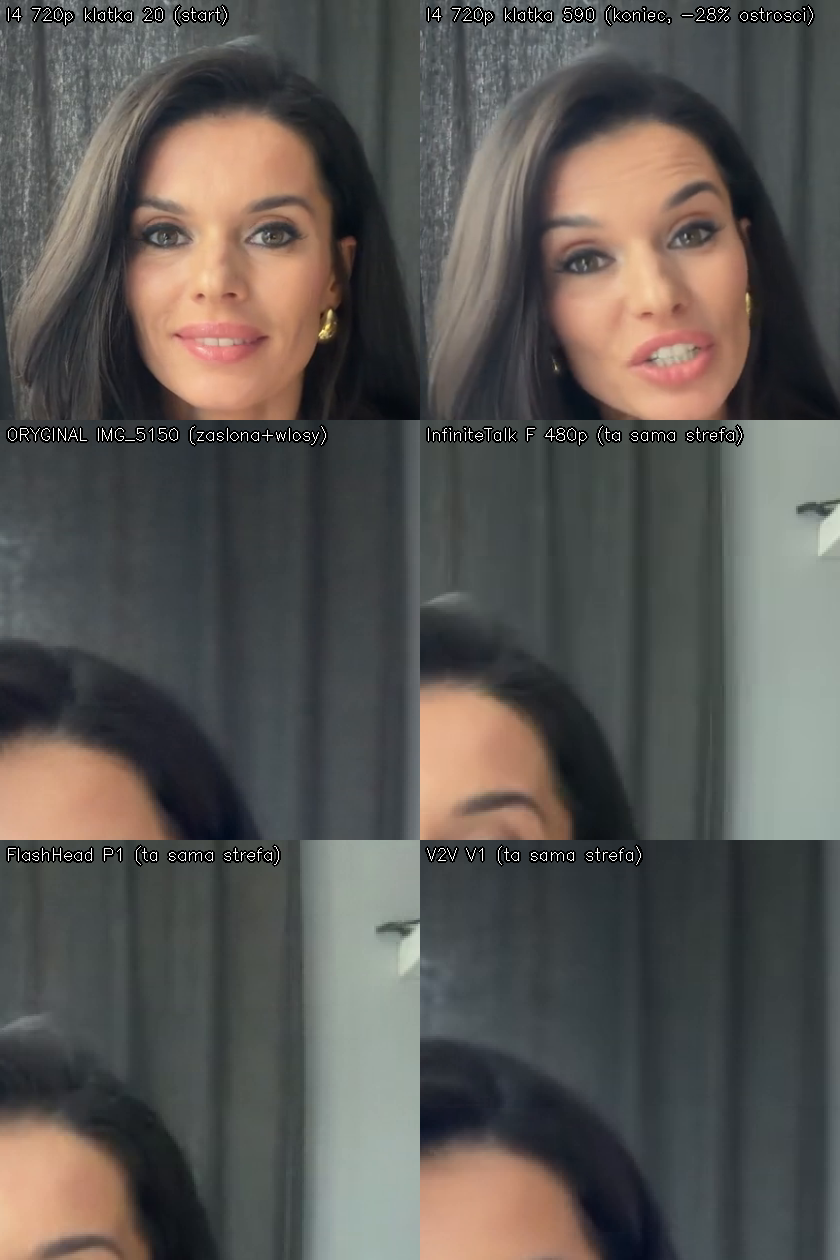
  3. Dryf w łańcuchach InfiniteTalk (I3/I4/F): każdy segment uczy się z poprzedniego → po 24 s ostrość −28 %, jasność +6, kontrast ↑, rysy twardsze. Same szwy między segmentami są niewidoczne. → dopasowanie kolorów do referencji, łańcuchy ≤ 30 s, a najlepiej V2V z prawdziwego nagrania (V1: zero szarpnięć, zero dryfu).
  4. „Plastik" i ziarno: modele w fp8 + 4–6 kroków z LoRA dają szum wysokiej częstotliwości (ostrość 71–106 vs 44 w oryginale — to nie detal). → test bf16 (pamięć GB10 pozwala), więcej kroków tam, gdzie nie ma bugu cfg, lekki filtr temporalny + upscale w post.
  5. Pulsowanie co ~1 s w FlashHead: zmiana na granicy paczki 2,6× większa niż wewnątrz (krótki kontekst ruchu). Plus: nieruchome ciało (o połowę mniej ruchu niż oryginał) i nagłe obroty głowy w wariancie pro. → tylko do awatara „na żywo" w kadrze twarzy.
  6. Rozdzielczość i kompresja: 480×832 oglądane na 1080×1920 (2,25×) uwidacznia szum; kompresja na stronę zabiera dodatkowe ~8–10 % ostrości. → 704×1280/768×1344 do finałów, upscale 2×, crf 18.
  7. Przekłamania w mowie (osobny problem, audio): LTX psuje pierwszą sekundę 4/8 kwestii i „w liczbę"; Chatterbox gubi ść/nosówki. → krótkie kwestie, 2 warianty + wybór po Whisperze, trudne słowa fonetycznie.

Grupy prób

LTX-2.3 — jeden model: obraz + głos + usta

L1

Baza: LTX-2.3 i2v, 8 ujęć, klon głosu z 5 s

Punkt odniesienia. Jeden model robi obraz, mowę po polsku i ruch ust naraz; głos sklonowany z 5 s referencji; obraz startuje z prawdziwej klatki Dominiki (3 klatki na zmianę).

Silnik

LTX-2.3 22B distilled fp8 (ComfyUI-h3, spark5) — jeden przebieg generuje wideo i audio

Wejście

3 klatki z nagrań (IMG_5110 @0.2 s, IMG_5137 @15.9 s, IMG_5125 @5.0 s) + 5 s głosu + 8 linijek tekstu w promptach (po jednej na ujęcie)

Modele / wagi

  • LTX-2.3 22B distilled (fp8) — model wideo+audioltx-2.3-22b-distilled-fp8.safetensors · źródło · checkpoint ComfyUI (zawiera VAE wideo i VAE audio); 29,5 GB
  • Gemma 3 12B IT (fp4 mixed) — enkoder tekstugemma_3_12B_it_fp4_mixed.safetensors · źródło · 9,4 GB

Ustawienia

rozdzielczość576×1024 (pion)
klatki/ujęcie201 = 8 s @ 25 fps
kroki8 (distilled, ManualSigmas 1.0→0.0)
samplereuler_cfg_pp, cfg 1.0
klon głosuLTXVReferenceAudio, 5 s referencji (IMG_5137 2.0–7.2 s), identity_guidance_scale 3.0
i2vLTXVImgToVideoInplace strength 1.0, LTXVPreprocess 18
dekoderVAEDecodeTiled 768/64

Wykonanie

węzełspark5 (GB10)
czas renderu1695 s za 8 ujęć (~212 s/ujęcie)
ComfyUI prompt_idd8a3f7a5-404a-44ef-8e5e-15ddb501a131
graf APIjobs/20260915-ltx-dominika-E-8shots/workflow.json (143 węzły)
Transkrypcja Whisper (large-v3, PL) — miara zrozumiałości
shot1 | Cześć, mam na imię Dominika i jestem z Numeriki. To jest test dłuższego tekstu.
shot2 | Lonian, Bartosz Paszek to najlepszy wspólnik. Trafił mi się jak ślepej kurze ziarno.
shot3 | Legia Warszawa to najlepszy klub. A kto nie wierzy, chuj mu w dziób.
shot4 | Kocham czarodziejkę z Księżyca i wiem, że 40 plus 60 daje 100.
shot5 | Także co wiem, jest taka super tajna formuła w Excelu. Nazywa się SUMA. Ale nikomu nie mówcie!
shot6 | Excel to jedyny program, który zamienia datę urodzenia w bliskie 44 tysiące.
shot7 | Otwierasz plik, a on pyta, czy zapisać zmiany. Jakie zmiany? Ja tylko patrzyłam.
shot8 | Gmurki to nie funkcja, to pułapka na ludzi, którzy ufają Excelowi. Koniec testu.

Ocena / uwagi

Tożsamość i mimika bardzo dobre. 4/8 linijek idealne, 4/8 z błędem w pierwszej sekundzie (doklejona sylaba, dodany wstęp, 'Gmurki' zamiast 'Scal komórki') — LTX ma niestabilny start kwestii. Ogony ciszy przycięte do końca mowy (+0,45 s).

L2

720p: LTX-2.3 w 704×1280

Ta sama konfiguracja co L1, wyższa rozdzielczość (704×1280 zamiast 576×1024).

Silnik

LTX-2.3 22B distilled fp8 (ComfyUI-h3)

Wejście

jak L1 (linijki 1–8)

Modele / wagi

  • LTX-2.3 22B distilled (fp8) — model wideo+audioltx-2.3-22b-distilled-fp8.safetensors · źródło · checkpoint ComfyUI (zawiera VAE wideo i VAE audio); 29,5 GB
  • Gemma 3 12B IT (fp4 mixed) — enkoder tekstugemma_3_12B_it_fp4_mixed.safetensors · źródło · 9,4 GB

Ustawienia

rozdzielczość704×1280 (pion, 720p)
klatki/ujęcie201 = 8 s @ 25 fps
kroki8 (distilled, ManualSigmas 1.0→0.0)
samplereuler_cfg_pp, cfg 1.0
klon głosuLTXVReferenceAudio, 5 s referencji (IMG_5137 2.0–7.2 s), identity_guidance_scale 3.0
i2vLTXVImgToVideoInplace strength 1.0, LTXVPreprocess 18
dekoderVAEDecodeTiled 768/64

Wykonanie

węzełspark6
czas renderu2868 s (GPU)
ComfyUI prompt_id5a4862a7-0671-4ce6-9d5a-aab0b568b224
graf APIjobs/20260915-L2-ltx-720p/workflow.json
Transkrypcja Whisper (large-v3, PL) — miara zrozumiałości
shot1 | Cześć! Mam na imię Dominika i jestem z Numeriki. To jest test dłuższego tekstu.
shot2 | Pienodogę. Bartosz Paszek to najlepszy wspólnik. Trafił mi się jak ślepej kurze ziarno.
shot3 | Ja, Trogłaśka. Legia Warszawa to najlepszy klub, a kto nie wierzy, chuj mu w dziób.
shot4 | Kocham czarodzieńkę z księżyca I wiem, że 40 plus 60 daje 100
shot5 | Jest taka super tajna formuła w Excelu, nazywa się suma, ale nikomu nie mówcie.
shot6 | Excel to jedyny program, który zamienia datę urodzenia w bliskę 44 tysiące.
shot7 | Otwierasz plik, a on pyta czy zapisać zmiany. Jakie zmiany? Ja tylko patrzyłam.
shot8 | To pułapka na ludzi, którzy ufają Excelowi. Koniec testu.

Ocena / uwagi

Obraz wyraźnie ostrzejszy niż L1 (oczy, skóra, włosy — porównanie kadrów 1:1 w tej samej sekundzie), tożsamość i mimika jak w L1. Koszt: 2881 s za 8 ujęć (360 s/ujęcie, 1,7× dłużej niż 576×1024). Mowa: 5/8 idealnie, 2/8 z doklejoną sylabą/słowem na starcie („Pienodogę.", „Ja, Trogłaśka."), 1/8 z uciętym początkiem (shot 8 bez „Scal komórki to nie funkcja") — problem pierwszej sekundy nie zależy od rozdzielczości.

L4

Lek na zjadaną 1. sekundę: „bierze krótki oddech, potem mówi”

Jak L1, ale prompt każe najpierw wziąć oddech — sprawdzamy, czy początek kwestii przestaje ginąć.

Silnik

LTX-2.3 22B distilled fp8 (ComfyUI-h3)

Wejście

jak L1 (linijki 1–8)

Modele / wagi

  • LTX-2.3 22B distilled (fp8) — model wideo+audioltx-2.3-22b-distilled-fp8.safetensors · źródło · checkpoint ComfyUI (zawiera VAE wideo i VAE audio); 29,5 GB
  • Gemma 3 12B IT (fp4 mixed) — enkoder tekstugemma_3_12B_it_fp4_mixed.safetensors · źródło · 9,4 GB

Ustawienia

rozdzielczość576×1024 (pion)
klatki/ujęcie201 = 8 s @ 25 fps
kroki8 (distilled, ManualSigmas 1.0→0.0)
samplereuler_cfg_pp, cfg 1.0
klon głosuLTXVReferenceAudio, 5 s referencji (IMG_5137 2.0–7.2 s), identity_guidance_scale 3.0
i2vLTXVImgToVideoInplace strength 1.0, LTXVPreprocess 18
dekoderVAEDecodeTiled 768/64
promptShe takes a short breath, then says in Polish: „…”

Wykonanie

węzełspark5
czas renderu1676 s (GPU)
ComfyUI prompt_idad4527f7-5aab-45d3-9484-6ead4b0a3d0b
graf APIjobs/20260915-L4-ltx-breath/workflow.json
Transkrypcja Whisper (large-v3, PL) — miara zrozumiałości
shot1 | Cześć, mam na imię Dominika i jestem z Numeriki. To jest test dłuższego tekstu.
shot2 | Bartosz Paszek to najlepszy wspólnik. Trafił mi się jak ślepej kurze ziarno.
shot3 | Dzięki za oglądanie!
shot4 | Kocham czarodziejkę z Księżyca i wiem, że 40 plus 60 daje 100.
shot5 | Jest taka super tajna formuła w Excelu, nazywa się suma, ale nikomu nie mówcie.
shot6 | Excel to jedyny program, który zamienia datę urodzenia w bliskie 44 tysiące.
shot7 | Otwierasz plik, a on pyta, czy zapisać zmiany. Jakie zmiany? Ja tylko patrzyłam.
shot8 | Bóg to nie funkcja, to pułapka na ludzi, którzy ufają Excelowi. Koniec testu.

Ocena / uwagi

Lepiej niż baza: 6/8 linijek idealnie (w L1 były 4/8) — „oddech" naprawił początki linijek 2 i 5. Ale linijka 3 wyszła jako bełkot bez treści (w L1 była idealna), a 8 znów ma zjedzony start („Bóg to nie funkcja" zamiast „Scal komórki to nie funkcja"). Wniosek: sztuczka pomaga statystycznie, nie deterministycznie — przy produkcji trzeba generować 2 warianty na linijkę i wybierać po Whisperze. „w liczbę" konsekwentnie wychodzi jako „w bliskie" (L1, L2, L4) — słowo do przepisania w skrypcie. 1676 s GPU (8 ujęć).

L5

LTXVModalityGuidance 3.0 (sprzężenie audio↔wideo)

Jak L1 na linijkach 1–4 + dodatkowy przebieg z odciętą uwagą audio↔wideo, wynik dopychany do wersji sprzężonej (mocniejszy lip-sync).

Silnik

LTX-2.3 22B distilled fp8 (ComfyUI-h3)

Wejście

jak L1 (linijki 1–4)

Modele / wagi

  • LTX-2.3 22B distilled (fp8) — model wideo+audioltx-2.3-22b-distilled-fp8.safetensors · źródło · checkpoint ComfyUI (zawiera VAE wideo i VAE audio); 29,5 GB
  • Gemma 3 12B IT (fp4 mixed) — enkoder tekstugemma_3_12B_it_fp4_mixed.safetensors · źródło · 9,4 GB

Ustawienia

rozdzielczość576×1024 (pion)
klatki/ujęcie201 = 8 s @ 25 fps
kroki8 (distilled, ManualSigmas 1.0→0.0)
samplereuler_cfg_pp, cfg 1.0
klon głosuLTXVReferenceAudio, 5 s referencji (IMG_5137 2.0–7.2 s), identity_guidance_scale 3.0
i2vLTXVImgToVideoInplace strength 1.0, LTXVPreprocess 18
dekoderVAEDecodeTiled 768/64
modality_guidance3.0 (0–100 % kroków)

Wykonanie

węzełspark6
czas renderu1082 s (GPU)
ComfyUI prompt_idb8082747-9ff6-4d25-a5b8-009a366a0628
graf APIjobs/20260915-L5-ltx-mg3/workflow.json
Transkrypcja Whisper (large-v3, PL) — miara zrozumiałości
shot1 | pagiem. Cześć, mam na imię Dominika i jestem z Numeriki. To jest test dłuższego tekstu.
shot2 | Barczosz Paszek to najlepszy wspólnik. Grafił mi się jak ślepej kurze ziarno.
shot3 | Legia Warszawera to najlepszy klub, a kto nie wierzy, chuj mu w dziób.
shot4 | Kocham czarodziejkę z Księżyca i wiem, że 40 plus 60 daje 100.

Ocena / uwagi

Usta pracują wyraźnie mocniej (szerokie otwarcia, zęby, język), ale pojawiają się przerysowane/zdeformowane kształty warg w pojedynczych klatkach i więcej rozmycia ruchu. Mowa NIE lepsza: 4/4 linijki z drobnymi zniekształceniami („pagiem." na starcie, „Barczosz", „Grafił", „Warszawera") — w bazie 3/4 idealne. Koszt +27 % czasu (1082 s za 4 ujęcia = 270 s/ujęcie vs 212). Wniosek: przy modelu distilled modality_scale 3.0 to za dużo; ewentualnie 1.5 do sprawdzenia, ale nie jest to priorytet.

L6

LTXVSpatioTemporalGuidance 1.0 (detal i koherencja ruchu)

Jak L1 na linijkach 1–4 + STG (blok 29): przebieg z osłabioną self-attention i odpychanie od niego.

Silnik

LTX-2.3 22B distilled fp8 (ComfyUI-h3)

Wejście

jak L1 (linijki 1–4)

Modele / wagi

  • LTX-2.3 22B distilled (fp8) — model wideo+audioltx-2.3-22b-distilled-fp8.safetensors · źródło · checkpoint ComfyUI (zawiera VAE wideo i VAE audio); 29,5 GB
  • Gemma 3 12B IT (fp4 mixed) — enkoder tekstugemma_3_12B_it_fp4_mixed.safetensors · źródło · 9,4 GB

Ustawienia

rozdzielczość576×1024 (pion)
klatki/ujęcie201 = 8 s @ 25 fps
kroki8 (distilled, ManualSigmas 1.0→0.0)
samplereuler_cfg_pp, cfg 1.0
klon głosuLTXVReferenceAudio, 5 s referencji (IMG_5137 2.0–7.2 s), identity_guidance_scale 3.0
i2vLTXVImgToVideoInplace strength 1.0, LTXVPreprocess 18
dekoderVAEDecodeTiled 768/64
stgscale 1.0, blocks 29

Wykonanie

węzełspark6
czas renderu1125 s (GPU)
ComfyUI prompt_id54b0aa23-d182-4611-8d61-5c942452324d
graf APIjobs/20260915-L6-ltx-stg1/workflow.json
Transkrypcja Whisper (large-v3, PL) — miara zrozumiałości
shot1 | Cześć, mam na imię Dominika i jestem z Numeriki. To jest test dłuższego tekstu.
shot2 | Bartosz Paszek to najlepszy wspólnik. Trafił mi się jak ślepej kurze ziarno.
shot3 | Legia Warsamyza to najlepszy klub. A kto nie wierzy? Chuj mu w dziób!
shot4 | Kocham czarodziejkę z Księżyca i wiem, że 40 plus 60 daje 100.

Ocena / uwagi

Mowa dobra (3/4 idealnie, „Warsamyza"). Obraz: STG 1.0 dokłada kontrastu i „wygładza" skórę, a mimika robi się przerysowana — szeroki, sztuczny uśmiech w porównaniu z naturalnym z L1 (patrz kadry 1:1 w 3. sekundzie ujęcia 1). Koszt +33 % czasu (1125 s za 4 ujęcia = 281 s/ujęcie). Wniosek: dla talking-head z prawdziwej klatki STG nie pomaga; ewentualnie 0.3–0.5, ale nie ma po co.

L7

Ciągłe ujęcie bez cięć: extend (LTXVAddGuide)

Linijki 1–3 jako łańcuch: każde kolejne ujęcie startuje z ostatnich 9 klatek poprzedniego (guide @ klatka 0), overlap przycięty — 24 s bez cięcia montażowego.

Silnik

LTX-2.3 22B distilled fp8 (ComfyUI-h3)

Wejście

jak L1 (linijki 1–3)

Modele / wagi

  • LTX-2.3 22B distilled (fp8) — model wideo+audioltx-2.3-22b-distilled-fp8.safetensors · źródło · checkpoint ComfyUI (zawiera VAE wideo i VAE audio); 29,5 GB
  • Gemma 3 12B IT (fp4 mixed) — enkoder tekstugemma_3_12B_it_fp4_mixed.safetensors · źródło · 9,4 GB

Ustawienia

rozdzielczość576×1024 (pion)
klatki/ujęcie201 = 8 s @ 25 fps
kroki8 (distilled, ManualSigmas 1.0→0.0)
samplereuler_cfg_pp, cfg 1.0
klon głosuLTXVReferenceAudio, 5 s referencji (IMG_5137 2.0–7.2 s), identity_guidance_scale 3.0
i2vLTXVImgToVideoInplace strength 1.0, LTXVPreprocess 18
dekoderVAEDecodeTiled 768/64
łańcuchLTXVAddGuide(frame_idx 0, strength 1.0) z 9 ostatnich klatek + LTXVCropGuides
klatka startowaIMG_5110 @0.2 s (tylko 1. ujęcie)

Wykonanie

węzełspark5
czas renderu667 s (GPU)
ComfyUI prompt_id837d523d-abca-4b54-9610-039586a067ee
graf APIjobs/20260915-L7-ltx-extend/workflow.json
Transkrypcja Whisper (large-v3, PL) — miara zrozumiałości
shot1 | Cześć, mam na imię Dominika i jestem z Numeriki. To jest test dłuższego tekstu.
shot2 | bo Aron do psa na sercu chłopcy tchma w karszołusz. Bartosz Paszek to najlepszy wspólnik. Trafił mi się jak ślepej kurze ziarno.
shot3 | Legia Warszawa to najlepszy klub, a kto nie wierzy, chuj mu w dziób.

Ocena / uwagi

Obraz: łączenie ujęć BEZSZWOWE — poza, mrugnięcie i światło przechodzą płynnie z ujęcia 1 do 2 (ostatnie 9 klatek jako guide), zero cięcia montażowego. Dźwięk: problem — ujęcie 2 zaczyna się od ~3 s bełkotu („bo Aron do psa na sercu…") zanim padnie właściwa kwestia; model „kontynuuje mowę" z klatek-guide, bo guide niesie tylko obraz, nie audio. Linijki 1 i 3 idealne. 667 s GPU za 3 ujęcia (222 s/ujęcie). Do naprawienia: prompt „milczy przez sekundę, potem mówi" albo przycięcie bełkotu po Whisperze — obraz jest wart dalszej pracy.

L8

Jedno długie ujęcie 24 s: LTXVContextWindows

Linijki 1–3 w JEDNYM prompcie, 601 klatek generowanych oknami 145/40 (pyramid, FreeNoise, retain_first_frame).

Silnik

LTX-2.3 22B distilled fp8 (ComfyUI-h3)

Wejście

jak L1 (linijki 1–3)

Modele / wagi

  • LTX-2.3 22B distilled (fp8) — model wideo+audioltx-2.3-22b-distilled-fp8.safetensors · źródło · checkpoint ComfyUI (zawiera VAE wideo i VAE audio); 29,5 GB
  • Gemma 3 12B IT (fp4 mixed) — enkoder tekstugemma_3_12B_it_fp4_mixed.safetensors · źródło · 9,4 GB

Ustawienia

rozdzielczość576×1024 (pion)
klatki/ujęcie601 = 24 s
kroki8 (distilled, ManualSigmas 1.0→0.0)
samplereuler_cfg_pp, cfg 1.0
klon głosuLTXVReferenceAudio, 5 s referencji (IMG_5137 2.0–7.2 s), identity_guidance_scale 3.0
i2vLTXVImgToVideoInplace strength 1.0, LTXVPreprocess 18
dekoderVAEDecodeTiled 768/64
context windows145 klatek, overlap 40, standard_uniform, pyramid, freenoise, retain_first_frame

Wykonanie

węzełspark6
czas renderu967 s (GPU)
ComfyUI prompt_id2d1e12db-3a8f-462f-950c-47339895f496
graf APIjobs/20260915-L8-ltx-cw/workflow.json
Transkrypcja Whisper (large-v3, PL) — miara zrozumiałości
long | stracił mi się jak ślepej kurzy ziarno. Legia Warszawa to najlepszy klub, a kto nie wierzy, chuj mu w dziób. A kto nie wierze, chuj mu ziarno? Legia Warszowa to najlepszy klub, a kto nie wierszy, chuj mu w diób. Legia Warszwa to najlepszy klub, a кто не вяжет, хуй ему в дзёб. Legia Warszava to najlepszy клуб, a kto не вяжет хуй ему в дзюб.

Ocena / uwagi

NIE DZIAŁA dla mowy. Obraz: 24 s stabilne, tożsamość OK, ale prawie bez ruchu ust — mimika „na jałowym biegu". Dźwięk: model zgubił linijkę 1, zaczął od końcówki 2, a potem ZAPĘTLIŁ linijkę 3 czterokrotnie, z każdą powtórką bardziej zniekształconą (ostatnie dwie przechodzą w rosyjskobrzmiący bełkot). Przyczyna: okna kontekstu widzą ten sam prompt, więc każde okno generuje tę samą kwestię. 967 s GPU za 24 s. Wniosek: długie kwestie tylko przez łańcuch ujęć (L1/L7), nie przez ContextWindows.

L10

ID-LoRA TalkVid (oficjalny klon głosu LTX-2.3)

Jak L1 + LoRA identyfikacji mówcy od Lightricks (trenowana na TalkVid) — dopiero z nią węzeł ReferenceAudio działa tak, jak zaprojektowano; L1 używał samego modelu bazowego.

Silnik

LTX-2.3 22B distilled fp8 (ComfyUI-h3)

Wejście

jak L1 (linijki 1–8)

Modele / wagi

  • LTX-2.3 22B distilled (fp8) — model wideo+audioltx-2.3-22b-distilled-fp8.safetensors · źródło · checkpoint ComfyUI (zawiera VAE wideo i VAE audio); 29,5 GB
  • Gemma 3 12B IT (fp4 mixed) — enkoder tekstugemma_3_12B_it_fp4_mixed.safetensors · źródło · 9,4 GB
  • LTX-2.3 ID-LoRA TalkVid 3kltx-2.3-id-lora-talkvid-3k.safetensors · źródło · 1,16 GB

Ustawienia

rozdzielczość576×1024 (pion)
klatki/ujęcie201 = 8 s @ 25 fps
kroki8 (distilled, ManualSigmas 1.0→0.0)
samplereuler_cfg_pp, cfg 1.0
klon głosuLTXVReferenceAudio, 5 s referencji (IMG_5137 2.0–7.2 s), identity_guidance_scale 3.0
i2vLTXVImgToVideoInplace strength 1.0, LTXVPreprocess 18
dekoderVAEDecodeTiled 768/64
id_loraltx-2.3-id-lora-talkvid-3k.safetensors, strength 1.0
_models[{'name': 'LTX-2.3 ID-LoRA TalkVid 3k', 'file': 'ltx-2.3-id-lora-talkvid-3k.safetensors', 'source': 'https://huggingface.co/Comfy-Org/ltx-2.3/tree/main/split_files/loras', 'note': '1,16 GB'}]

Wykonanie

węzełspark5
czas renderu1695 s (GPU)
ComfyUI prompt_id912cc59b-8f26-4a47-946e-c08d64a23ff1
graf APIjobs/20260915-L10-ltx-idlora-talkvid/workflow.json
Transkrypcja Whisper (large-v3, PL) — miara zrozumiałości
shot1 | Cześć, mam na imię Dominika i jestem z Numeriki. To jest test dłuższego tekstu.
shot2 | Bartosz Paszek to najlepszy wspólnik. Trafił mi się jak ślepej kurzy ziarno.
shot3 | Legia Warczawa to najlepszy klub, a kto nie wierzy...
shot4 | Kocham czarodziejkę z Księżyca i wiem, że 40 plus 60 daje 100.
shot5 | Przerzekłały. Jest taka super tajna formuła w Excelu. Nazywa się suma, ale nikomu nie mówcie.
shot6 | Excel to jedyny program, który zamienia datę urodzenia w łyskę 44 tysiące.
shot7 | Otwierasz plik, a on pyta, czy zapisać zmiany. Jakie zmiany? Ja tylko patrzyłam.
shot8 | Skał komórki to nie funkcja, to pułapka na ludzi, którzy ufają Excelowi. Koniec testu.

Ocena / uwagi

Zrozumiałość jak w bazie: 4/8 idealnie, 1/8 ucięty KONIEC („a kto nie wierzy…" bez puenty), 2/8 z doklejką/zniekształceniem na starcie („Przerzekłały.", „w łyskę"), „Skał komórki". Podobieństwo głosu (kosinus embeddingu mówcy, Chatterbox VoiceEncoder): vs oryginał A 0,848 / vs oryginał B (niewidziany) 0,794 — baza L1: 0,832 / 0,773; sufit „ona vs ona" 0,862; obcy głos (Piper) 0,69/0,63. Czyli ID-LoRA TalkVid podnosi podobieństwo tembru o ~0,02 — mierzalnie, ale nie skokowo. 1695 s GPU (jak baza).

L11

ID-LoRA CelebV-HQ (drugi wariant klonu głosu)

Jak L10, inna LoRA identyfikacji (CelebV-HQ), linijki 1–4.

Silnik

LTX-2.3 22B distilled fp8 (ComfyUI-h3)

Wejście

jak L1 (linijki 1–4)

Modele / wagi

  • LTX-2.3 22B distilled (fp8) — model wideo+audioltx-2.3-22b-distilled-fp8.safetensors · źródło · checkpoint ComfyUI (zawiera VAE wideo i VAE audio); 29,5 GB
  • Gemma 3 12B IT (fp4 mixed) — enkoder tekstugemma_3_12B_it_fp4_mixed.safetensors · źródło · 9,4 GB
  • LTX-2.3 ID-LoRA CelebV-HQ 3kltx-2.3-id-lora-celebvhq-3k.safetensors · źródło · 1,16 GB

Ustawienia

rozdzielczość576×1024 (pion)
klatki/ujęcie201 = 8 s @ 25 fps
kroki8 (distilled, ManualSigmas 1.0→0.0)
samplereuler_cfg_pp, cfg 1.0
klon głosuLTXVReferenceAudio, 5 s referencji (IMG_5137 2.0–7.2 s), identity_guidance_scale 3.0
i2vLTXVImgToVideoInplace strength 1.0, LTXVPreprocess 18
dekoderVAEDecodeTiled 768/64
id_loraltx-2.3-id-lora-celebvhq-3k.safetensors, strength 1.0
_models[{'name': 'LTX-2.3 ID-LoRA CelebV-HQ 3k', 'file': 'ltx-2.3-id-lora-celebvhq-3k.safetensors', 'source': 'https://huggingface.co/Comfy-Org/ltx-2.3/tree/main/split_files/loras', 'note': '1,16 GB'}]

Wykonanie

węzełspark6
czas renderu872 s (GPU)
ComfyUI prompt_idf780d226-8d39-437f-a3e9-f0e06b755bfb
graf APIjobs/20260915-L11-ltx-idlora-celebvhq/workflow.json
Transkrypcja Whisper (large-v3, PL) — miara zrozumiałości
shot1 | Cześć! Mam na imię Dominika i jestem z Numeriki. To jest test dłuższego tekstu.
shot2 | Bartosz Paszek to najlepszy wspólnik. Trafił mi się jak ślepej kurze ziarno.
shot3 | Legia Warszaniwa to najlepszy klub, a kto nie wierzy, chuj mu w dzi...
shot4 | Kocham czarodziejkę z Księżyca i wiem, że 40 plus 60 daje jej szt.

Ocena / uwagi

Zrozumiałość: 2/4 idealnie, 2/4 z uciętym KOŃCEM („chuj mu w dzi…", „daje jej szt." zamiast „daje sto") — ta LoRA częściej gubi końcówkę kwestii. Podobieństwo tembru (kosinus): 0,871 vs oryginał A / 0,797 vs oryginał B — najwyżej z wariantów LTX (baza 0,832/0,773, TalkVid 0,848/0,794), ale różnica vs TalkVid mieści się w szumie seedów (~0,015). 872 s GPU za 4 ujęcia (218 s/ujęcie).

L9

Inny model: Wan 2.2 I2V 14B — b-roll bez mowy

Wan 2.2 nie generuje mowy; pokazuje, jak inny model animuje tę samą klatkę (do przebitek między ujęciami z mową).

Silnik

Wan 2.2 I2V A14B fp8 (high-noise + low-noise) + lightx2v 4-step LoRA (ComfyUI-h3)

Wejście

klatka IMG_5125 @5.0 s + prompt „uśmiecha się, patrzy na laptop, pisze, kiwa głową”

Modele / wagi

  • Wan 2.2 I2V A14B high-noise (fp8)wan2.2_i2v_high_noise_14B_fp8_scaled.safetensors · źródło
  • Wan 2.2 I2V A14B low-noise (fp8)wan2.2_i2v_low_noise_14B_fp8_scaled.safetensors · źródło
  • lightx2v 4-step LoRA high/lowwan2.2_i2v_lightx2v_4steps_lora_v1_{high,low}_noise.safetensors · źródło
  • umt5-xxl fp8umt5_xxl_fp8_e4m3fn_scaled.safetensors · źródło
  • Wan 2.1 VAEwan_2.1_vae.safetensors · źródło

Ustawienia

rozdzielczość480×832
klatki81 @ 16 fps (5 s)
kroki4 (2 high-noise / 2 low-noise), cfg 1.0, euler simple, shift 5.0
seed2026091509

Wykonanie

węzełspark5
czas renderu111 s (GPU)
ComfyUI prompt_id2ada7052-4a96-4378-9fa8-6a01fa29fd74
graf APIjobs/20260915-L9-wan22-broll/workflow.json

InfiniteTalk — obraz pod gotowy dźwięk

I1

InfiniteTalk z PRAWDZIWYM audio (3,24 s) — test synchronizacji

Lewo oryginał, prawo InfiniteTalk z jednej klatki + jej prawdziwe nagranie (IMG_5110). Zapętlone 3×. Sprawdza, czy usta idą za dźwiękiem.

Silnik

InfiniteTalk (Wan 2.1 I2V 14B + patch InfiniteTalk), ComfyUI-h3 natywnie, spark8

Wejście

klatka IMG_5110 @0.2 s + audio IMG_5110 0,0–3,24 s (16 kHz, loudnorm −18)

Modele / wagi

  • Wan 2.1 I2V 14B 480p (fp8 scaled) — model wideowan2.1_i2v_480p_14B_fp8_scaled.safetensors · źródło · 16,4 GB
  • InfiniteTalk single-speaker (fp16) — patch audio→ustawan2.1_infiniteTalk_single_fp16.safetensors · źródło · 5,1 GB; MeiGen-AI/InfiniteTalk, Apache-2.0
  • lightx2v I2V 480p cfg/step-distill LoRA (rank 64)lightx2v_I2V_14B_480p_cfg_step_distill_rank64_bf16.safetensors · źródło · 6 kroków, cfg 1 — konieczne na GB10 (bug batchowania cond+uncond przy cfg>1)
  • chinese-wav2vec2-base — enkoder audiochinese-wav2vec2-base.bin · źródło · 380 MB
  • umt5-xxl (fp8) — enkoder tekstuumt5_xxl_fp8_e4m3fn_scaled.safetensors · źródło
  • CLIP ViT-H — enkoder klatki referencyjnejclip_vision_h.safetensors · źródło
  • Wan 2.1 VAEwan_2.1_vae.safetensors · źródło

Ustawienia

rozdzielczość480×832 (pion)
segment1 × 81 klatek (3,24 s)
kroki6, euler, scheduler normal, cfg 1.0 (LoRA lightx2v)
audio_scale1.0
klatka startowaIMG_5110 @0.2 s (480×832)
łańcuchprevious_frames = ostatnie 18 klatek poprzedniego segmentu + audio pre-cięte per segment; overlap 9 klatek przycięty przy sklejaniu

Wykonanie

węzełspark8
czas renderu184 s (GPU)
ComfyUI prompt_idaf702721-0a75-47b9-9f69-b9e090484c88
graf APIjobs/20260915-infinitetalk-dominika-D2-lightx2v/workflow.json

Ocena / uwagi

Tożsamość 1:1, usta w rytm mowy (start 0,8 s z głosem, zamknięcie w pauzie), model dodaje własne ruchy głowy i mrugnięcia. Wersja z cfg 4 / 20 kroków (D1) padła na bugu batchowania cond+uncond (ComfyUI upstream), stąd LoRA lightx2v + cfg 1.

I2

InfiniteTalk 44 s: głos Chatterbox (lokalny klon TTS)

Jeden ciągły klip z jednej klatki; dźwięk = 8 linijek z Chatterbox Multilingual (klon z 10 s próbki).

Silnik

InfiniteTalk (Wan 2.1 I2V 14B + patch), ComfyUI-h3 natywnie

Wejście

klatka IMG_5110 @0.2 s + audio G (Chatterbox, 44,2 s)

Modele / wagi

  • Wan 2.1 I2V 14B 480p (fp8 scaled) — model wideowan2.1_i2v_480p_14B_fp8_scaled.safetensors · źródło · 16,4 GB
  • InfiniteTalk single-speaker (fp16) — patch audio→ustawan2.1_infiniteTalk_single_fp16.safetensors · źródło · 5,1 GB; MeiGen-AI/InfiniteTalk, Apache-2.0
  • lightx2v I2V 480p cfg/step-distill LoRA (rank 64)lightx2v_I2V_14B_480p_cfg_step_distill_rank64_bf16.safetensors · źródło · 6 kroków, cfg 1 — konieczne na GB10 (bug batchowania cond+uncond przy cfg>1)
  • chinese-wav2vec2-base — enkoder audiochinese-wav2vec2-base.bin · źródło · 380 MB
  • umt5-xxl (fp8) — enkoder tekstuumt5_xxl_fp8_e4m3fn_scaled.safetensors · źródło
  • CLIP ViT-H — enkoder klatki referencyjnejclip_vision_h.safetensors · źródło
  • Wan 2.1 VAEwan_2.1_vae.safetensors · źródło

Ustawienia

rozdzielczość480×832 (pion)
segment81 klatek @ 25 fps, motion_frame_count 9 → 72 nowych klatek/segment
kroki6, euler, scheduler normal, cfg 1.0 (LoRA lightx2v)
audio_scale1.0
klatka startowaIMG_5110 @0.2 s (480×832)
łańcuchprevious_frames = ostatnie 18 klatek poprzedniego segmentu + audio pre-cięte per segment; overlap 9 klatek przycięty przy sklejaniu
segmenty16 × 81 klatek

Wykonanie

węzełspark8
czas renderu2747 s (GPU)
ComfyUI prompt_id3dbaf2e0-357f-41ec-b100-ad0710fc7e13
graf APIjobs/20260915-infinitetalk-F2-chatterbox-chain/workflow.json

Ocena / uwagi

Obraz: tożsamość stabilna przez 44 s (16 segmentów, bez dryfu koloru i twarzy), łączenia segmentów niewidoczne. Usta idą za dźwiękiem, ale dźwięk jest słabym ogniwem — Chatterbox zjada „ść" i nosówki (patrz T2). 2747 s GPU = ~172 s na segment 3,24 s → ~53× wolniej niż czas rzeczywisty na jednym GB10.

I3

InfiniteTalk 60 s: głos z LTX (klon z 5 s)

Jeden ciągły klip z jednej klatki; dźwięk = ścieżka audio z L1 (LTX-2.3 mówi jej głosem).

Silnik

InfiniteTalk (Wan 2.1 I2V 14B + patch), ComfyUI-h3 natywnie

Wejście

klatka IMG_5110 @0.2 s + audio z L1 (60,3 s)

Modele / wagi

  • Wan 2.1 I2V 14B 480p (fp8 scaled) — model wideowan2.1_i2v_480p_14B_fp8_scaled.safetensors · źródło · 16,4 GB
  • InfiniteTalk single-speaker (fp16) — patch audio→ustawan2.1_infiniteTalk_single_fp16.safetensors · źródło · 5,1 GB; MeiGen-AI/InfiniteTalk, Apache-2.0
  • lightx2v I2V 480p cfg/step-distill LoRA (rank 64)lightx2v_I2V_14B_480p_cfg_step_distill_rank64_bf16.safetensors · źródło · 6 kroków, cfg 1 — konieczne na GB10 (bug batchowania cond+uncond przy cfg>1)
  • chinese-wav2vec2-base — enkoder audiochinese-wav2vec2-base.bin · źródło · 380 MB
  • umt5-xxl (fp8) — enkoder tekstuumt5_xxl_fp8_e4m3fn_scaled.safetensors · źródło
  • CLIP ViT-H — enkoder klatki referencyjnejclip_vision_h.safetensors · źródło
  • Wan 2.1 VAEwan_2.1_vae.safetensors · źródło

Ustawienia

rozdzielczość480×832 (pion)
segment81 klatek @ 25 fps, motion_frame_count 9 → 72 nowych klatek/segment
kroki6, euler, scheduler normal, cfg 1.0 (LoRA lightx2v)
audio_scale1.0
klatka startowaIMG_5110 @0.2 s (480×832)
łańcuchprevious_frames = ostatnie 18 klatek poprzedniego segmentu + audio pre-cięte per segment; overlap 9 klatek przycięty przy sklejaniu
segmenty21 × 81 klatek

Wykonanie

węzełspark8
czas renderu3600 s (GPU)
ComfyUI prompt_id37f0f377-8942-4c83-a22a-f3bb80c5a882
graf APIjobs/20260915-infinitetalk-F-ltxvoice-chain/workflow.json

Ocena / uwagi

Najdłuższy klip: 60,3 s, 21 segmentów, 3600 s GPU (~171 s/segment, 60× czas rzeczywisty na jednym GB10). Tożsamość stabilna od pierwszej do ostatniej sekundy (bez dryfu twarzy, koloru i tła), łączenia segmentów niewidoczne, usta pracują w rytm mowy (zaokrąglone „o", uśmiechy, otwarte samogłoski). Głos = ścieżka z L1, więc dziedziczy jej błędy pierwszej sekundy. Miękkość obrazu 480p — patrz I4 (720p).

I5

InfiniteTalk: bliższa klatka + audio_scale 1.5

Linijki 1–3 (głos z LTX). Inna klatka startowa (IMG_5125 @5.0 s, bliższy kadr) i mocniejsze sprzężenie z dźwiękiem (audio_scale 1.5 zamiast 1.0).

Silnik

InfiniteTalk (Wan 2.1 I2V 14B + patch), ComfyUI-h3 natywnie

Wejście

klatka IMG_5125 @5.0 s (480×832) + audio z L1, linijki 1–3 (24,5 s)

Modele / wagi

  • Wan 2.1 I2V 14B 480p (fp8 scaled) — model wideowan2.1_i2v_480p_14B_fp8_scaled.safetensors · źródło · 16,4 GB
  • InfiniteTalk single-speaker (fp16) — patch audio→ustawan2.1_infiniteTalk_single_fp16.safetensors · źródło · 5,1 GB; MeiGen-AI/InfiniteTalk, Apache-2.0
  • lightx2v I2V 480p cfg/step-distill LoRA (rank 64)lightx2v_I2V_14B_480p_cfg_step_distill_rank64_bf16.safetensors · źródło · 6 kroków, cfg 1 — konieczne na GB10 (bug batchowania cond+uncond przy cfg>1)
  • chinese-wav2vec2-base — enkoder audiochinese-wav2vec2-base.bin · źródło · 380 MB
  • umt5-xxl (fp8) — enkoder tekstuumt5_xxl_fp8_e4m3fn_scaled.safetensors · źródło
  • CLIP ViT-H — enkoder klatki referencyjnejclip_vision_h.safetensors · źródło
  • Wan 2.1 VAEwan_2.1_vae.safetensors · źródło

Ustawienia

rozdzielczość480×832 (pion)
segment81 klatek @ 25 fps, motion_frame_count 9 → 72 nowych klatek/segment
kroki6, euler, scheduler normal, cfg 1.0 (LoRA lightx2v)
audio_scale1.5
klatka startowaIMG_5125 @5.0 s (480×832)
łańcuchprevious_frames = ostatnie 18 klatek poprzedniego segmentu + audio pre-cięte per segment; overlap 9 klatek przycięty przy sklejaniu
segmenty9 × 81 klatek

Wykonanie

węzełspark7
czas renderu1538 s (GPU)
ComfyUI prompt_id4ff22a42-2f63-45d8-8606-f903028fb908
graf APIjobs/20260915-I5-infinitetalk-as15-5125/workflow.json

Ocena / uwagi

Bliższy kadr + audio_scale 1.5: usta pracują wyraźnie mocniej (szerokie „o", uśmiech z zębami, zaokrąglone wargi), więcej mimiki i ruchu głowy niż przy 1.0 — miejscami aż za dużo (przerysowane kształty ust w połowie słów). Tożsamość stabilna przez 24,5 s. 1538 s GPU za 9 segmentów (~171 s/segment) — czas nie zależy od audio_scale.

I4

InfiniteTalk 720p (wan2.1_i2v_720p)

Linijki 1–3 (głos z LTX) w 720×1280 na bazie Wan 2.1 I2V 720p — ten sam patch InfiniteTalk i LoRA lightx2v (480p, działa też z 720p).

Silnik

InfiniteTalk (Wan 2.1 I2V 14B + patch), ComfyUI-h3 natywnie

Wejście

klatka IMG_5110 @0.2 s (720×1280) + audio z L1, linijki 1–3 (24,5 s)

Modele / wagi

  • Wan 2.1 I2V 14B 720p (fp8 scaled) — model wideowan2.1_i2v_720p_14B_fp8_scaled.safetensors · źródło · 16,4 GB
  • InfiniteTalk single-speaker (fp16) — patch audio→ustawan2.1_infiniteTalk_single_fp16.safetensors · źródło · 5,1 GB; MeiGen-AI/InfiniteTalk, Apache-2.0
  • lightx2v I2V 480p cfg/step-distill LoRA (rank 64)lightx2v_I2V_14B_480p_cfg_step_distill_rank64_bf16.safetensors · źródło · 6 kroków, cfg 1 — konieczne na GB10 (bug batchowania cond+uncond przy cfg>1)
  • chinese-wav2vec2-base — enkoder audiochinese-wav2vec2-base.bin · źródło · 380 MB
  • umt5-xxl (fp8) — enkoder tekstuumt5_xxl_fp8_e4m3fn_scaled.safetensors · źródło
  • CLIP ViT-H — enkoder klatki referencyjnejclip_vision_h.safetensors · źródło
  • Wan 2.1 VAEwan_2.1_vae.safetensors · źródło

Ustawienia

rozdzielczość720×1280 (pion, 720p)
segment81 klatek @ 25 fps, motion_frame_count 9 → 72 nowych klatek/segment
kroki6, euler, scheduler normal, cfg 1.0 (LoRA lightx2v)
audio_scale1.0
klatka startowaIMG_5110 @0.2 s (720×1280)
łańcuchprevious_frames = ostatnie 18 klatek poprzedniego segmentu + audio pre-cięte per segment; overlap 9 klatek przycięty przy sklejaniu
segmenty9 × 81 klatek

Wykonanie

węzełspark7
czas renderu5331 s (GPU)
ComfyUI prompt_id2b11b911-cb72-45fb-9a74-909d40618fa2
graf APIjobs/20260915-I4-infinitetalk-720p/workflow.json

Ocena / uwagi

Najlepszy obraz w całym teście: 720×1280 wyraźnie ostrzejsze niż 480p (oczy, rzęsy, kosmyki — porównanie kadrów 1:1), tożsamość stabilna, usta w rytm mowy, naturalne ruchy głowy. Cena: 5331 s GPU za 24,5 s = 592 s/segment (3,5× dłużej niż 480p; 60 s klipu = ~3,5 h na jednym GB10). Ta sama LoRA lightx2v 480p działa z bazą 720p.

Sam głos — porównanie

T

Linijka 1 w pięciu wersjach

T1 — LTX-2.3 klon z 5 s (ścieżka z L1)
T2 — Chatterbox Multilingual, próbka A (10 s)
T3 — Chatterbox Multilingual, próbka B (12 s), exaggeration 0.3
T4 — Piper pl_PL-gosia (głos syntetyczny, NIE klon — punkt odniesienia)
T5 — ORYGINAŁ A: 10 s prawdziwego nagrania (próbka referencyjna Chatterboxa)
T6 — LTX-2.3 + ID-LoRA TalkVid (z L10)
T7 — ORYGINAŁ B: 12 s z IMG_5150 (nagranie, którego żaden model nie widział)
T8 — LTX-2.3 + ID-LoRA CelebV-HQ (z L11)

Ten sam tekst: „Cześć! Mam na imię Dominika i jestem z Numeriki. To jest test dłuższego tekstu.” Odsłuchaj i porównaj z oryginałem (T5).

Silnik

T1: LTX-2.3 (ReferenceAudio) · T2/T3: Chatterbox Multilingual 0.1.4 (Resemble AI, MIT; venv na spark8) · T4: Piper 1.2 (Tank, CPU)

Wejście

T1: 5 s ref (IMG_5137) · T2: 10 s z datasetu · T3: 12 s z datasetu · T4: brak (głos Gosia)

Modele / wagi

  • Chatterbox MultilingualResembleAI/chatterbox (t3_mtl23ls_v2, s3gen, ve) · źródło
  • Piper pl_PL-gosia-mediumpl_PL-gosia-medium.onnx · źródło

Ustawienia

Chatterboxlanguage_id=pl, exaggeration 0.45/0.3, cfg_weight 0.5, temperature 0.7/0.6, 24 kHz
Whisper T2„Cze! Mam na imię Dominika i jestem z Numeriki…”
Whisper T3„Czeeej! Mam na imię Dominika, jestem z Numeriki…”
podobieństwo mówcy (kosinus, Chatterbox VoiceEncoder) vs oryginał A / vs oryginał BT1 LTX 0,832 / 0,773 · T2 Chatterbox A 0,912* / 0,807 · T3 Chatterbox B 0,860 / 0,792 · T4 Piper 0,689 / 0,634 · T6 LTX+ID-LoRA TalkVid 0,848 / 0,794 · T8 LTX+ID-LoRA CelebV-HQ 0,871 / 0,797 · L2 (720p) 0,845 / 0,820 · L4 0,846 / 0,820 · sufit ona-vs-ona (A vs B) 0,862 (*T2 klonował z A, więc wynik vs A jest zawyżony)

Wykonanie

Ocena / uwagi

Wniosek z liczb: wszystkie klony leżą między „obcy głos” (0,63–0,69) a „ona vs ona” (0,86). Tembr: Chatterbox najbliżej (0,81 vs niewidziane nagranie), LTX+ID-LoRA i LTX 720p tuż za (0,79–0,82), LTX baza 0,77. Ale Chatterbox przegrywa wyraźnie na polskiej fonetyce (Whisper), więc do produkcji: LTX. Miara ma słabość: to enkoder z pakietu Chatterbox, może faworyzować własny model. ElevenLabs nieużyty (klucz w konfiguracji to ID klucza, nie klucz API).

Faza 2 — nowe silniki (S2V, V2V, SoulX-FlashHead, LongCat)

S1

S2V — ustawienia szablonu (10 kroków, cfg 6)

Pierwsza próba nowego silnika: jedna paczka 4,8 s.

Silnik

Wan 2.2 S2V 14B (ComfyUI-h3 natywnie, spark8)

Wejście

klatka IMG_5110 @0.2 s + audio z L1 (linijki 1–3, głos LTX)

Modele / wagi

  • Wan 2.2 S2V 14B (fp8 scaled) — model audio→wideowan2.2_s2v_14B_fp8_scaled.safetensors · źródło · 16,4 GB; Wan-AI/Wan2.2-S2V-14B, Apache-2.0
  • wav2vec2-large-english (fp16) — enkoder audiowav2vec2_large_english_fp16.safetensors · źródło · 631 MB
  • umt5-xxl (fp8) — enkoder tekstuumt5_xxl_fp8_e4m3fn_scaled.safetensors · źródło
  • Wan 2.1 VAEwan_2.1_vae.safetensors · źródło

Ustawienia

rozdzielczość480×832 (pion)
klatki77 na paczkę @ 16 fps (4,8 s)
węzełWanSoundImageToVideo (+ WanSoundImageToVideoExtend dla kolejnych paczek)
ModelSamplingSD3shift 8
klatka referencyjnaIMG_5110 @0.2 s (480×832)
audiościeżka z L1 (LTX, głos Dominiki), linijki 1–3
kroki10, uni_pc simple, cfg 6.0

Wykonanie

węzełspark8
czas renderu414 s (GPU)
ComfyUI prompt_id71b29c42-fed6-462c-82ed-31baed233546
graf APIjobs/20260915-S1-s2v-test/workflow.json

Ocena / uwagi

Pierwsza próba S2V z ustawieniami szablonu (10 kroków, cfg 6): obraz i tożsamość OK, ale usta jako jaskrawoczerwona, przerysowana plama (artefakt wysokiego CFG w fp8). Naprawione w S2a (cfg 4) i S2b (LoRA, cfg 1). 414 s GPU.

S2a

S2V — cfg 4, 20 kroków (naprawa ust)

Jak S1, ale niższe CFG i więcej kroków; negatyw rozszerzony o „red lipstick / oversaturated lips”.

Silnik

Wan 2.2 S2V 14B (ComfyUI-h3 natywnie, spark8)

Wejście

klatka IMG_5110 @0.2 s + audio z L1 (linijki 1–3, głos LTX)

Modele / wagi

  • Wan 2.2 S2V 14B (fp8 scaled) — model audio→wideowan2.2_s2v_14B_fp8_scaled.safetensors · źródło · 16,4 GB; Wan-AI/Wan2.2-S2V-14B, Apache-2.0
  • wav2vec2-large-english (fp16) — enkoder audiowav2vec2_large_english_fp16.safetensors · źródło · 631 MB
  • umt5-xxl (fp8) — enkoder tekstuumt5_xxl_fp8_e4m3fn_scaled.safetensors · źródło
  • Wan 2.1 VAEwan_2.1_vae.safetensors · źródło

Ustawienia

rozdzielczość480×832 (pion)
klatki77 na paczkę @ 16 fps (4,8 s)
węzełWanSoundImageToVideo (+ WanSoundImageToVideoExtend dla kolejnych paczek)
ModelSamplingSD3shift 8
klatka referencyjnaIMG_5110 @0.2 s (480×832)
audiościeżka z L1 (LTX, głos Dominiki), linijki 1–3
kroki20, uni_pc simple, cfg 4.0

Wykonanie

węzełspark8
czas renderu811 s (GPU)
ComfyUI prompt_id054eeb78-07da-457f-b530-d489365d7347
graf APIjobs/20260915-S2a-s2v-cfg4/workflow.json

Ocena / uwagi

S2V (Wan 2.2 Sound-to-Video), wariant „pełny”: 20 kroków, cfg 4, negatyw z „czerwone usta”. Artefakt z S1 (cfg 6: jaskrawoczerwone, przerysowane usta) zniknął — usta naturalne, ruch subtelny, tożsamość i tło idealne. Koszt: 811 s GPU za 4,8 s (77 klatek @16 fps) — 8× wolniej niż wariant z LoRA.

S2b

S2V + LoRA lightx2v — 4 kroki, cfg 1

Szybki wariant z oficjalnego szablonu: LoRA dystylacyjna, 4 kroki, bez CFG.

Silnik

Wan 2.2 S2V 14B (ComfyUI-h3 natywnie, spark8)

Wejście

klatka IMG_5110 @0.2 s + audio z L1 (linijki 1–3, głos LTX)

Modele / wagi

  • Wan 2.2 S2V 14B (fp8 scaled) — model audio→wideowan2.2_s2v_14B_fp8_scaled.safetensors · źródło · 16,4 GB; Wan-AI/Wan2.2-S2V-14B, Apache-2.0
  • wav2vec2-large-english (fp16) — enkoder audiowav2vec2_large_english_fp16.safetensors · źródło · 631 MB
  • lightx2v T2V 4-step LoRA v1.1 (high-noise)wan2.2_t2v_lightx2v_4steps_lora_v1.1_high_noise.safetensors · źródło · tylko S2b/S3 (4 kroki, cfg 1)
  • umt5-xxl (fp8) — enkoder tekstuumt5_xxl_fp8_e4m3fn_scaled.safetensors · źródło
  • Wan 2.1 VAEwan_2.1_vae.safetensors · źródło

Ustawienia

rozdzielczość480×832 (pion)
klatki77 na paczkę @ 16 fps (4,8 s)
węzełWanSoundImageToVideo (+ WanSoundImageToVideoExtend dla kolejnych paczek)
ModelSamplingSD3shift 8
klatka referencyjnaIMG_5110 @0.2 s (480×832)
audiościeżka z L1 (LTX, głos Dominiki), linijki 1–3
kroki4, uni_pc simple, cfg 1.0
LoRAwan2.2_t2v_lightx2v_4steps_lora_v1.1_high_noise, strength 1.0

Wykonanie

węzełspark8
czas renderu97 s (GPU)
ComfyUI prompt_id1d828640-4396-466e-82d8-e94d96d90911
graf APIjobs/20260915-S2b-s2v-lightx2v/workflow.json

Ocena / uwagi

S2V + LoRA lightx2v (wan2.2_t2v v1.1 high-noise), 4 kroki, cfg 1: NAJSZYBSZY silnik w całym teście — 97 s GPU za 4,8 s (77 klatek @16 fps, 480×832). Usta naturalne (bez artefaktu z S1), ruch warg subtelny (S2V mówi „delikatniej” niż InfiniteTalk), tożsamość 1:1, lekki ruch głowy. Wada: 16 fps (InfiniteTalk 25 fps).

S3

S2V — łańcuch 6 paczek (~28 s), LoRA 4 kroki

Linijki 1–3 w jednym ciągłym klipie: 6 × 77 klatek przez WanSoundImageToVideoExtend (kolejne paczki kontynuują z poprzedniego latentu).

Silnik

Wan 2.2 S2V 14B (ComfyUI-h3 natywnie, spark8)

Wejście

klatka IMG_5110 @0.2 s + audio z L1 (linijki 1–3, głos LTX)

Modele / wagi

  • Wan 2.2 S2V 14B (fp8 scaled) — model audio→wideowan2.2_s2v_14B_fp8_scaled.safetensors · źródło · 16,4 GB; Wan-AI/Wan2.2-S2V-14B, Apache-2.0
  • wav2vec2-large-english (fp16) — enkoder audiowav2vec2_large_english_fp16.safetensors · źródło · 631 MB
  • lightx2v T2V 4-step LoRA v1.1 (high-noise)wan2.2_t2v_lightx2v_4steps_lora_v1.1_high_noise.safetensors · źródło · tylko S2b/S3 (4 kroki, cfg 1)
  • umt5-xxl (fp8) — enkoder tekstuumt5_xxl_fp8_e4m3fn_scaled.safetensors · źródło
  • Wan 2.1 VAEwan_2.1_vae.safetensors · źródło

Ustawienia

rozdzielczość480×832 (pion)
klatki77 na paczkę @ 16 fps (4,8 s)
węzełWanSoundImageToVideo (+ WanSoundImageToVideoExtend dla kolejnych paczek)
ModelSamplingSD3shift 8
klatka referencyjnaIMG_5110 @0.2 s (480×832)
audiościeżka z L1 (LTX, głos Dominiki), linijki 1–3
kroki4, uni_pc simple, cfg 1.0
LoRAwan2.2_t2v_lightx2v_4steps_lora_v1.1_high_noise
łańcuch6 paczek × 77 klatek; latent kumulowany LatentConcat(t) jak w szablonie Comfy-Org (pierwsza wersja bez kumulacji dała tylko 4,8 s — poprawione)

Wykonanie

węzełspark8
czas renderu432 s (GPU)
ComfyUI prompt_id1e41a617-7d61-4b0e-9fbf-56bc30abbc56
graf APIjobs/20260915-S3b-s2v-chain/workflow.json

Ocena / uwagi

Ciągłe 30 s (481 klatek @16 fps) w 432 s GPU — ~14 s obliczeń na 1 s filmu, czyli 4× szybciej niż InfiniteTalk 480p (53 s/s) i 40× szybciej niż InfiniteTalk 720p. Tożsamość i tło stabilne przez cały klip, łączenia paczek (co 4,8 s) niewidoczne, mimika naturalna, ruch ust subtelniejszy niż w InfiniteTalk. Audio ma 24,5 s — ostatnie 5 s to „słuchanie” (mowa się skończyła, model kontynuuje obraz). Pułapka: pierwsza wersja bez kumulacji latentu (LatentConcat) dała tylko 4,8 s — Extend liczy przesunięcie audio z długości podanego latentu.

V1

V2V DUBBING — jej prawdziwe nagranie (IMG_5150) z nowym tekstem

Zamiast jednej klatki podajemy CAŁE nagranie Dominiki: model zachowuje kadr, światło, ruch ciała i głowy z oryginału, a usta i mimikę generuje pod nowy dźwięk (linijki 1–3, głos LTX).

Silnik

InfiniteTalk V2V przez wrapper Kijai (ComfyUI-WanVideoWrapper) w osobnej instancji ComfyUI na spark8:8190

Wejście

IMG_5150.MOV 0–24,5 s → 480×832 @25 fps (613 klatek) + audio z L1 (24,5 s)

Modele / wagi

  • Wan 2.1 I2V 14B 720p (fp8 scaled, format Kijai) — model wideoWan2_1-I2V-14B-720p_fp8_e4m3fn_scaled_KJ.safetensors · źródło · 16,6 GB
  • InfiniteTalk single (fp16, format Kijai) — patch audio→ustaWan2_1-InfiniTetalk-Single_fp16.safetensors · źródło · 5,1 GB
  • lightx2v I2V 480p cfg/step-distill LoRAlightx2v_I2V_14B_480p_cfg_step_distill_rank64_bf16.safetensors · źródło
  • umt5-xxl enc (fp8, Kijai)umt5-xxl-enc-fp8_e4m3fn.safetensors · źródło
  • wav2vec2-chinese-base (fp16, Kijai)wav2vec2-chinese-base_fp16.safetensors · źródło
  • CLIP ViT-H (Comfy-Org)clip_vision_h.safetensors · źródło
  • Wan 2.1 VAE bf16 (Kijai)Wan2_1_VAE_bf16.safetensors · źródło
  • ComfyUI-WanVideoWrapper (custom node, osobna instancja :8190)custom_nodes/ComfyUI-WanVideoWrapper · źródło

Ustawienia

rozdzielczość480×832, 25 fps
oknoframe_window_size 81, motion_frame 9, mode infinitetalk
samplerWanVideoSampler 4 kroki, cfg 1.0, shift 11, dpm++_sde, start_step 2 (częściowe odszumianie latentu wideo), add_noise_to_samples
audioMultiTalkWav2VecEmbeds fps 25, audio_scale 1.0, normalize_loudness
modelbf16 + fp8_e4m3fn_scaled, attention sdpa (GB10 bez flash/sage)

Wykonanie

węzełspark8 (instancja :8190)
ComfyUI prompt_id5afd4750-f3ee-4bc7-95c6-2f98a1267ce8
graf APIjobs/20260915-V1-v2v-dubbing/workflow.json

Ocena / uwagi

DUBBING PRAWDZIWEGO NAGRANIA (V2V): wejście = IMG_5150 (76 s, tu pierwsze 24,5 s, przeskalowane do 480×832 @25 fps) + nowy dźwięk (linijki 1–3 z L1, głos LTX). Wynik 26,3 s (657 klatek), 1023 s GPU (~39 s obliczeń na 1 s filmu; wrapper Kijai w osobnej instancji ComfyUI :8190, wagi Kijai fp8 720p + InfiniteTalk single, LoRA lightx2v, 4 kroki, cfg 1, start_step 2 = częściowe odszumianie latentu źródłowego wideo). Obraz: to JEJ nagranie — kadr, światło z okna, marynarka, ruchy ciała i głowy z oryginału; usta i część mimiki przegenerowane pod nowy tekst; w kilku momentach spojrzenie/pochylenie głowy odbiega od źródła (model godzi ruch źródła z nową mową). Największe podobieństwo do „prawdziwej niej” z całego testu. Pułapki: rdzeniowy CLIPVisionLoader nie czyta pliku Kijai (open-clip-xlm-roberta…) — trzeba clip_vision_h z Comfy-Org; VHS/KJNodes zastąpione rdzeniowymi LoadVideo/GetVideoComponents/ImageFromBatch.

P1

SoulX-FlashHead LITE — awatar „na żywo” z jednej klatki

Model do streamingu (1,3B): klatka + audio → talking head paczkami po ~1 s; ten sam dźwięk co w I1/S1/V1 (linijki 1–3, głos LTX).

Silnik

SoulX-FlashHead 1.3B (lite) przez ComfyUI_RH_FlashHead w osobnej instancji ComfyUI na spark8:8190

Wejście

klatka IMG_5110 @0.2 s (480×832) + audio z L1 (linijki 1–3, 24,5 s)

Modele / wagi

  • SoulX-FlashHead 1.3B — Model_Lite (DiT audio→wideo, VAE LTX)Soul-AILab/SoulX-FlashHead-1_3B/Model_Lite/diffusion_pytorch_model.safetensors · źródło · 5,7 GB; wariant czasu rzeczywistego
  • SoulX-FlashHead 1.3B — Model_Pro (DiT audio→wideo, VAE Wan 2.1)Soul-AILab/SoulX-FlashHead-1_3B/Model_Pro/diffusion_pytorch_model.safetensors · źródło · 5,7 GB; wyższa jakość
  • VAE LTX (do lite) / Wan2.1_VAE.pth (do pro)VAE_LTX (1,6 GB) · VAE_Wan (485 MB) · źródło
  • wav2vec2-base-960h — enkoder audiowav2vec/facebook/wav2vec2-base-960h · źródło · 361 MB
  • ComfyUI_RH_FlashHead (custom node, ta sama osobna instancja :8190 co V1)custom_nodes/ComfyUI_RH_FlashHead · źródło

Ustawienia

rozdzielczość480×832 (pion), 25 fps
paczkaframe_num 33, motion_frames_latent_num 2 (kontekst z poprzedniej paczki), cached_audio_duration 8 s
kroki4 (distilled), sample_shift 5, color_correction 1.0
seed42
attentiontorch SDPA (fallback w kodzie — flash-attn nie jest potrzebny)
model_typelite (VAE LTX, stride czasowy 8 → 24 nowe klatki/paczkę)

Wykonanie

węzełspark8 (instancja :8190)
czas renderu70 s (GPU)
ComfyUI prompt_idab99fab0-0f49-4e07-85b6-642b3334703d
graf APIjobs/20260915-P1-flashhead-lite/workflow.json

Ocena / uwagi

Działa na GB10 bez FlashAttention (kod ma fallback na torch SDPA). Najszybszy silnik w całym teście: 24 s wideo w 70 s GPU (25 paczek po 24 klatki, ~1,7 s/paczka, model 1,3B). Tożsamość i kadr z klatki zachowane, mruganie naturalne, ciało nieruchome (to model „talking head”, nie animuje rąk). Usta ruszają się w rytm mowy, ale otwarcie jest skromne — mniej wyraziste niż w InfiniteTalk/LTX; na razie ocena po klatkach, wymaga odsłuchu z obrazem. Poprawka lokalna: węzeł RunningHub woła binarkę `ffmpeg`, której nie ma na spark8 → podmienione na binarkę z imageio-ffmpeg (nodes.py, backup .bak-orig).

P2

SoulX-FlashHead PRO — ten sam model, wariant jakościowy

Jak P1, ale Model_Pro z VAE Wan 2.1: wolniej, ostrzej, wyraźniejsze usta.

Silnik

SoulX-FlashHead 1.3B (pro) przez ComfyUI_RH_FlashHead w osobnej instancji ComfyUI na spark8:8190

Wejście

klatka IMG_5110 @0.2 s (480×832) + audio z L1 (linijki 1–3, 24,5 s)

Modele / wagi

  • SoulX-FlashHead 1.3B — Model_Lite (DiT audio→wideo, VAE LTX)Soul-AILab/SoulX-FlashHead-1_3B/Model_Lite/diffusion_pytorch_model.safetensors · źródło · 5,7 GB; wariant czasu rzeczywistego
  • SoulX-FlashHead 1.3B — Model_Pro (DiT audio→wideo, VAE Wan 2.1)Soul-AILab/SoulX-FlashHead-1_3B/Model_Pro/diffusion_pytorch_model.safetensors · źródło · 5,7 GB; wyższa jakość
  • VAE LTX (do lite) / Wan2.1_VAE.pth (do pro)VAE_LTX (1,6 GB) · VAE_Wan (485 MB) · źródło
  • wav2vec2-base-960h — enkoder audiowav2vec/facebook/wav2vec2-base-960h · źródło · 361 MB
  • ComfyUI_RH_FlashHead (custom node, ta sama osobna instancja :8190 co V1)custom_nodes/ComfyUI_RH_FlashHead · źródło

Ustawienia

rozdzielczość480×832 (pion), 25 fps
paczkaframe_num 33, motion_frames_latent_num 2 (kontekst z poprzedniej paczki), cached_audio_duration 8 s
kroki4 (distilled), sample_shift 5, color_correction 1.0
seed42
attentiontorch SDPA (fallback w kodzie — flash-attn nie jest potrzebny)
model_typepro (VAE Wan 2.1, stride czasowy 4 → 28 nowych klatek/paczkę)

Wykonanie

węzełspark8 (instancja :8190)
czas renderu305 s (GPU)
ComfyUI prompt_id1eabb4cd-9dad-4f53-ad28-baff657c0c49
graf APIjobs/20260915-P2-flashhead-pro/workflow.json

Ocena / uwagi

Wariant „pro” (VAE Wan 2.1 zamiast LTX): 23,5 s w 305 s GPU (21 paczek po 28 klatek, ~13 s/paczka) — 4,4× wolniej niż lite, ale nadal 2–3× szybciej niż InfiniteTalk 480p. Twarz ostrzejsza, usta otwierają się wyraźniej i szerzej niż w lite, lekkie ruchy głowy; sylwetka i tło nieruchome. Ten sam fallback SDPA i ta sama poprawka ffmpeg co w P1.

P3

SoulX-FlashHead LITE 512×512 — test „czasu rzeczywistego”

Natywna rozdzielczość modelu (kwadrat): tu GB10 liczy ~0,9× czasu rzeczywistego — to pomiar pod „awatara na żywo”.

Silnik

SoulX-FlashHead 1.3B (lite) przez ComfyUI_RH_FlashHead w osobnej instancji ComfyUI na spark8:8190

Wejście

klatka IMG_5110 @0.2 s (480×832) + audio z L1 (linijki 1–3, 24,5 s)

Modele / wagi

  • SoulX-FlashHead 1.3B — Model_Lite (DiT audio→wideo, VAE LTX)Soul-AILab/SoulX-FlashHead-1_3B/Model_Lite/diffusion_pytorch_model.safetensors · źródło · 5,7 GB; wariant czasu rzeczywistego
  • SoulX-FlashHead 1.3B — Model_Pro (DiT audio→wideo, VAE Wan 2.1)Soul-AILab/SoulX-FlashHead-1_3B/Model_Pro/diffusion_pytorch_model.safetensors · źródło · 5,7 GB; wyższa jakość
  • VAE LTX (do lite) / Wan2.1_VAE.pth (do pro)VAE_LTX (1,6 GB) · VAE_Wan (485 MB) · źródło
  • wav2vec2-base-960h — enkoder audiowav2vec/facebook/wav2vec2-base-960h · źródło · 361 MB
  • ComfyUI_RH_FlashHead (custom node, ta sama osobna instancja :8190 co V1)custom_nodes/ComfyUI_RH_FlashHead · źródło

Ustawienia

rozdzielczość512×512 (kadr = górna, kwadratowa część portretu IMG_5110), 25 fps
paczkaframe_num 33, motion_frames_latent_num 2 (kontekst z poprzedniej paczki), cached_audio_duration 8 s
kroki4 (distilled), sample_shift 5, color_correction 1.0
seed42
attentiontorch SDPA (fallback w kodzie — flash-attn nie jest potrzebny)
model_typelite (VAE LTX)

Wykonanie

węzełspark8 (instancja :8190)
czas renderu48 s (GPU)
ComfyUI prompt_ida784d27a-9b7a-497c-99b5-bed268f0e552
graf APIjobs/20260915-P3-flashhead-lite-512/workflow.json

Ocena / uwagi

Pomiar „czy to nadaje się na żywo”: w natywnej rozdzielczości modelu (512×512) lite liczy paczkę 0,96 s wideo w ~1,08 s → 0,9× czasu rzeczywistego na GB10 (48 s GPU na 24 s). Przy 480×832 (P1) ta sama paczka trwa 1,7 s → 0,56×. Wejście: kwadratowy kadr z góry portretu (twarz mała, dlatego usta słabo widać) — do awatara na żywo trzeba ciaśniejszego kadru twarzy. Ruch: mruganie, drobne ruchy głowy, usta w rytm mowy.